
新闻资讯
产品资讯丨发售前必读!NVIDIA DGX Spark 十大核心问题终极解答
2025年09月05日
DGX Spark 是什么?
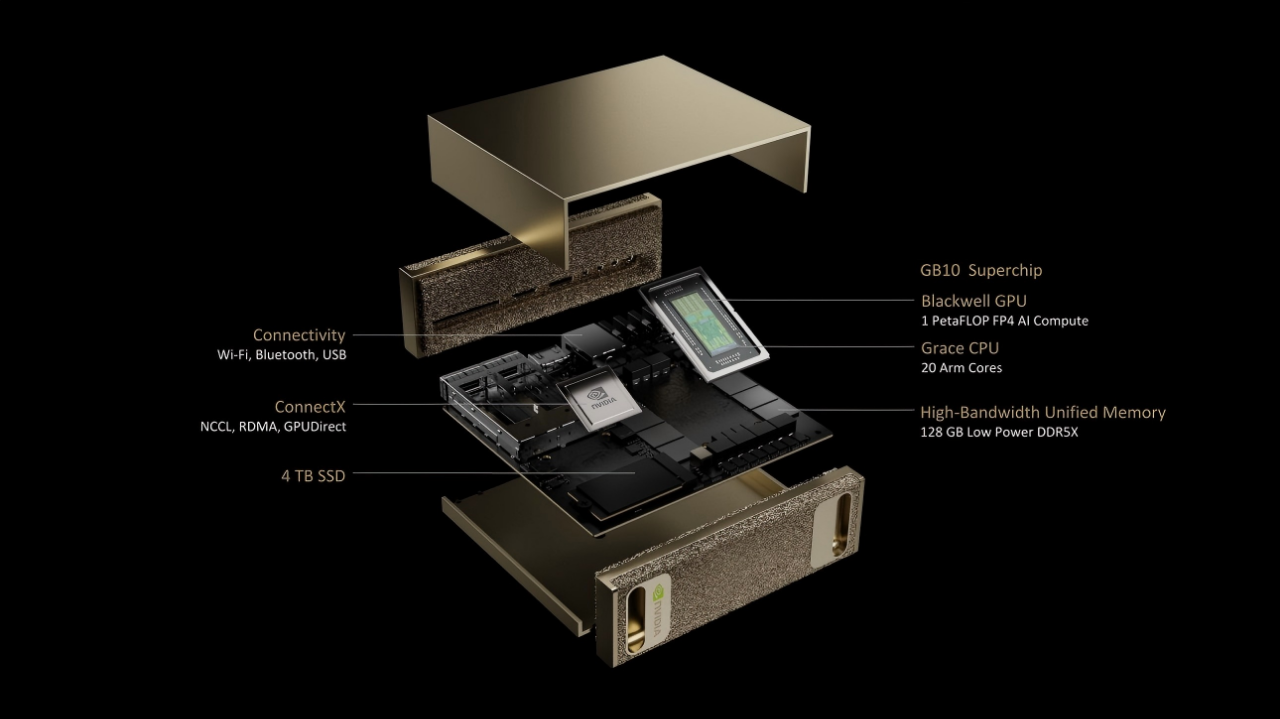
由 NVIDIA GB10 Grace Blackwell 超级芯片驱动的NVIDIA DGX™ Spark 以节能高效和紧凑外观,具备 1000 AI Tops(FP4精度)。借助预装的 NVIDIA AI 软件栈和 128GB 内存,开发者可以对 DeepSeek、Meta、Google 和其他公司的最新一代推理 AI 模型进行原型制作、微调和推理,这些模型在本地具有多达 200B个参数,并无缝部署到数据中心或云端。
DGX Spark 的目标用户是谁?
-
AI深度学习研究员和科学家:高性能本地算力,支持复杂模型研发与实验迭代
-
AI开发者和工程师:本地高性能工作站,加速开发流程,提高效率
-
AI初创公司和小型企业:低成本、高性价比的AI计算方案,支持敏捷开发与数据隐私保护
-
高等院校跟职业学院:人工智能、计算机科学等相关专业的教学与实验,教学实验平台,支持学生开展AI模型训练与实践项目
-
特定行业领域的研究团队:本地化高性能计算资源,满足数据合规与实时处理需求
DGX Spark 的应用场景有哪些?
-
AI研究与开发:适合进行大模型的原型设计、微调(Fine-Tuning)和推理(Inference)
-
数据科学:加速数据分析和机器学习工作流
-
边缘AI开发:为机器人、智慧城市、工业自动化等边缘应用开发和优化AI模型
-
教育领域:为高校和学生提供接触和学习尖端AI技术的实践平台
DGX Spark 的主要特点是什么?
-
核心算力:搭载 GB10 Grace Blackwell 超级芯片,集成20核ARM CPU与Blackwell架构GPU,FP4精度下AI性能达 1 PetaFLOP (每秒1000万亿次运算)
-
内存系统:128GB LPDDR5x 统一内存,带宽高达273GB/s,为大型AI模型提供高速数据吞吐
-
互联技术:采用 NVLink-C2C 互联技术,实现CPU与GPU内存一致性,带宽是PCIe 5.0的5倍,极大优化数据密集型任务效率
-
模型支持:单机可本地运行2000亿参数大模型,双机互联可扩展至处理4050亿参数的模型
-
存储与连接:支持 M.2 PCIe NVMe 存储(可选1TB或4TB),配备 Wi-Fi 7、蓝牙5.3、10GbE网卡、4个USB4接口和HDMI 2.1a输出
-
设计形态:体积仅150mm × 150mm × 50.5mm,重量约1.2kg,设计紧凑便携,桌面级设备
-
软件生态:预装 NVIDIA AI 企业级软件栈,包含CUDA、PyTorch等工具,并支持NVIDIA NIM 微服务,方便模型优化与部署,可实现与云端(如DGX Cloud)的无缝迁移
-
能效与供电:功耗约170瓦,可通过标准墙壁插座供电,能效比较高
DGX Spark 的电源功率要求是什么?
NVIDIA DGX Spark 的电源功率要求为 170 瓦(W),可通过标准墙壁插座直接供电,无需额外的高功率电源适配器
DGX Spark 的部署复杂度如何?
-
开箱即用:预装NVIDIA DGX OS,驱动、CUDA、cuDNN 等底层库,开箱即用,免去环境配置烦恼 ,软件通过NVIDIA Base Command™一键部署
-
混合云支持:无缝集成AWS、Azure等公有云,实现本地与云端资源统一调度
-
边缘部署:支持Docker容器化部署,适配工业网关、医疗设备等边缘节点
DGX Spark 的扩展性如何?
-
横向扩展:通过添加节点组建集群,算力线性增长(最高支持16节点)
-
纵向升级:兼容未来GPU架构(如Blackwell),硬件模块化设计降低升级成本
-
软件兼容性:持续更新AI框架与优化库,确保与最新算法(如Transformer、Diffusion模型)兼容
DGX Spark 是否支持行业定制化?
-
垂直领域加速:提供医疗影像分析(如DICOM格式处理)、金融风控(时间序列预测)等场景的预优化模型
-
硬件定制:可选配医疗级EMC认证机箱(适用于医院环境)或工业级防尘外壳(制造业场景)
-
生态合作:与西门子、GE医疗等合作伙伴共建行业解决方案库,覆盖超过15个垂直领域
DGX Spark 的软件生态包含哪些组件?
-
预装框架:PyTorch、TensorFlow、ONNX Runtime,开箱即用
-
优化库:CUDA 11.x、cuDNN 8.x、TensorRT 8.x,提升模型推理速度
-
部署工具:NVIDIA Triton Inference Server,支持多模型并发与动态批处理
-
管理平台:NVIDIA Base Command™,提供集群监控、作业调度与远程管理功能
DGX Spark 怎么购买?
DGX Spark全国首批预售火热进行中!扫描下方图灵智新官方客服二维码,实时获取专属报价与配置方案。
 |