
新闻资讯
CES 2026丨老黄扔下了一颗真正的「企业级核弹」
2026年01月27日
"在芯片快速进化的背后,AI需求正在急剧攀升,多条曲线同时发挥作用:模型参数规模正以每年约10倍的速度扩大,推理阶段的计算需求以每年约5倍的速度增长,而token成本则需要以每年约10倍的速度持续下降。"
2026年1月5日的CES2026,仁勋打破了一个延续五年的惯例首次在CES上未发布任何消费级显卡。没有RTX新品的欢呼,取而代之的是发布NVIDIARubin平台。
「Vera Rubin」计算平台:开启了新一代Al之旅
VeraRubin计算平台,系以发现暗物质的天文学家命名,该平台由六款专为打造超凡,Al超级计算机而设计的全新芯片组成。VeraRubin也树立了新的标杆,能以最低的成本构建、部署和安全运行全球最大型、最先进的AI系统,其目标只有一个:
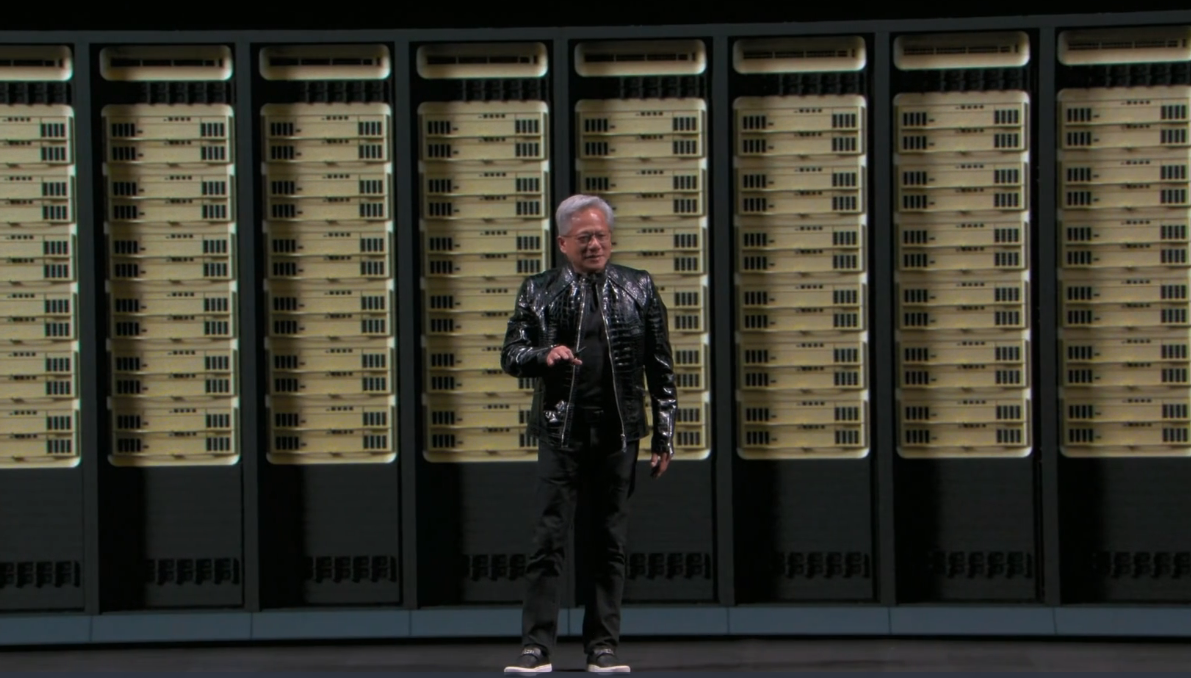
英伟达内部曾有铁律:每代产品最多迭代1-2颗核心芯片。
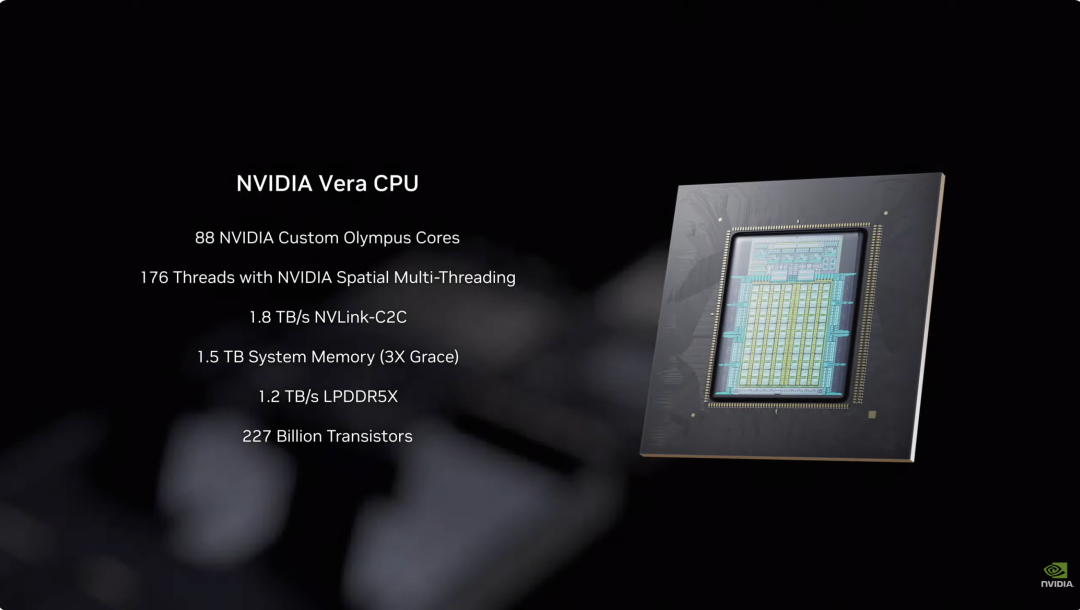
但Vera Rubin直接颠覆传统,一口气推出6款全新芯片并全面量产,用“极致协同设计”回应AI模型每年10倍的增长需求——不是优化单一部件,而是重构从芯片到系统的每一层级。
-
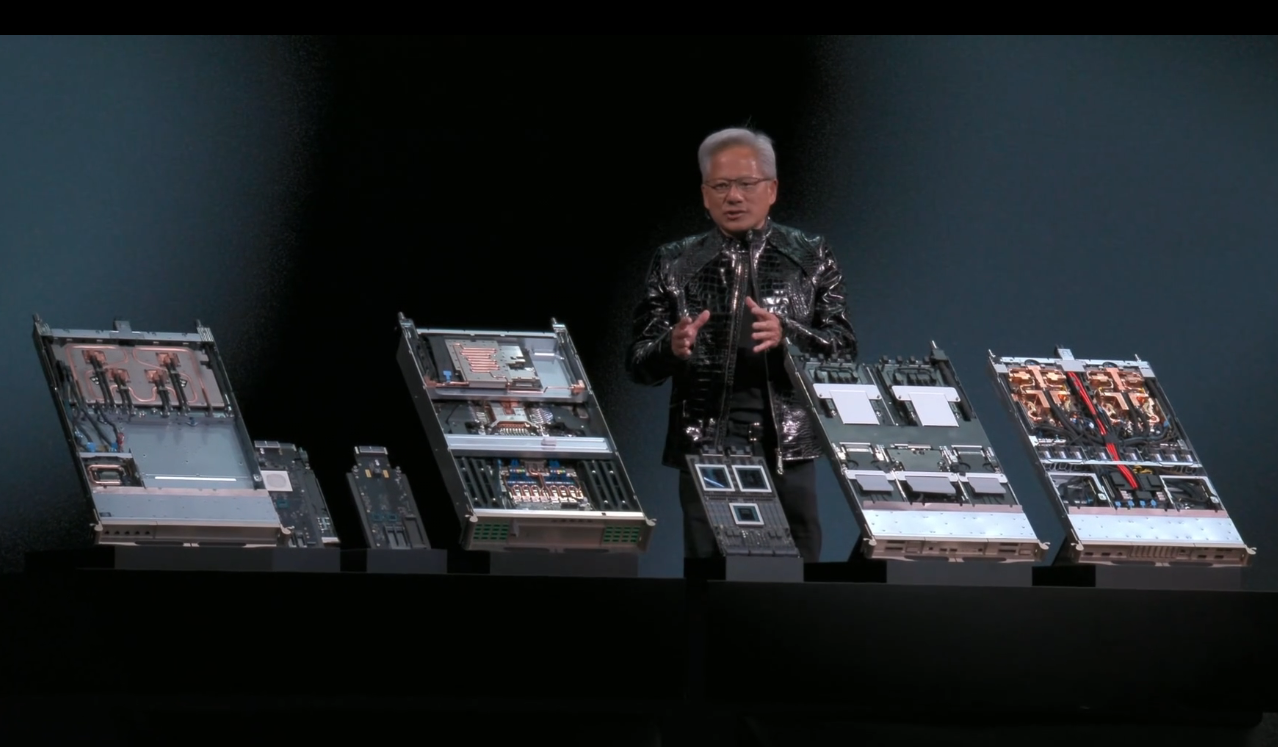
88 个 NVIDIA 定制 Olympus 核心 -
采用 NVIDIA 空间多线程技术,支持 176 个线程 -
NVLink C2C 带宽 1.8 TB/s -
系统内存 1.5 TB(为 Grace 的 3 倍) -
LPDDR5X 带宽 1.2 TB/s -
2270 亿个晶体管
-
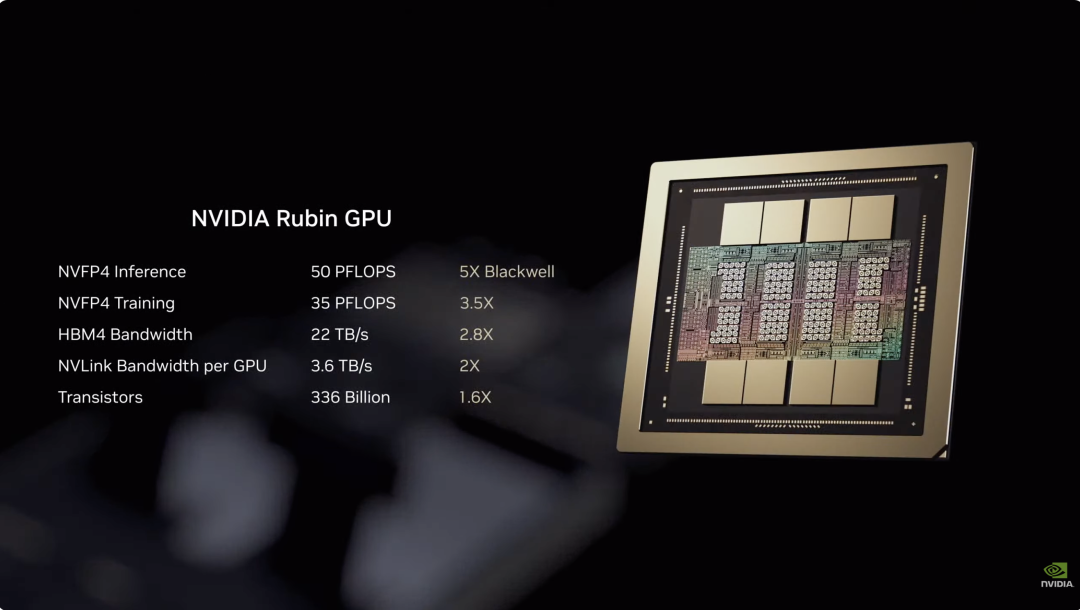
NVFP4推理算力50PFLOPS,是前代 Blackwell的5倍 -
拥有 3360 亿晶体管,比 Blackwell 晶体管数量增加了 1.6 倍 -
搭载第三代Transformer引擎,能根据 Transformer 模型需求动态调整精度
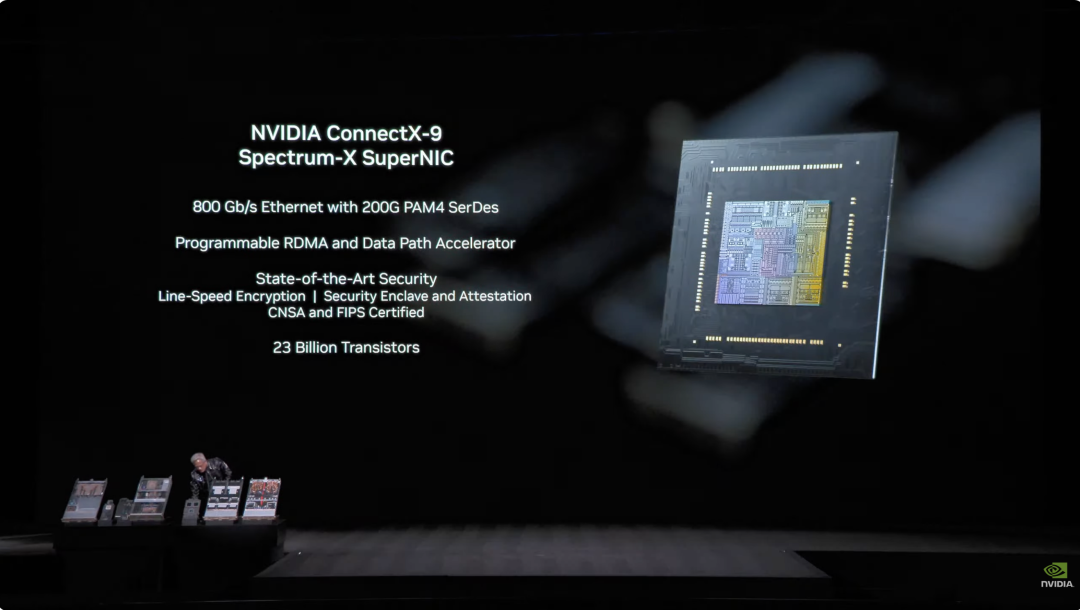
-
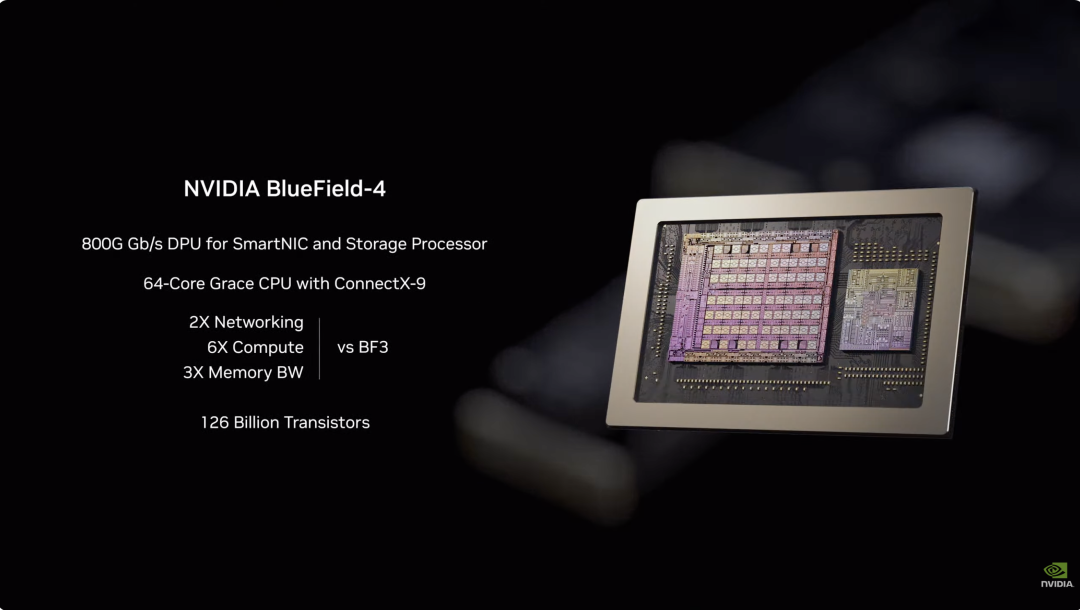
专为新一代 AI 存储平台而构建的端到端的引擎 -
面向 SmartNIC 与存储处理器的 800G Gb/s DPU -
搭配 ConnectX-9 的 64 核 Grace CPU -
1260 亿个晶体管
-
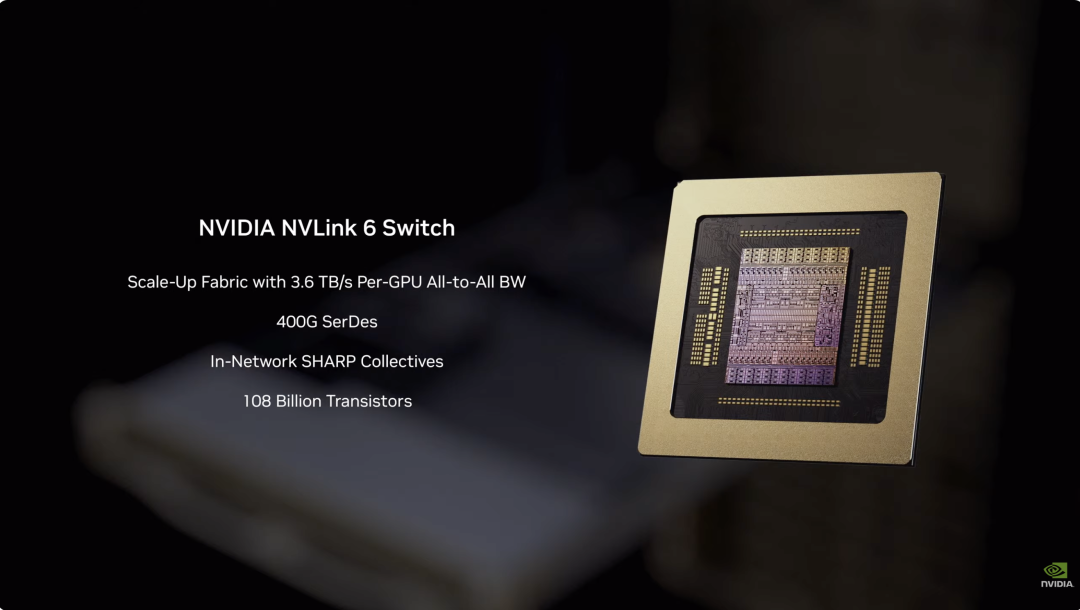
连接 18 个计算节点,支持最多 72 个 Rubin GPU 像一个整体协同运行 -
在 NVLink 6 架构下,每个 GPU 可获得 3.6 TB 每秒的 all-to-all 通信带宽 -
采用 400G SerDes,支持 In-Network SHARP Collectives,可在交换网络内部完成集合通信操作
-
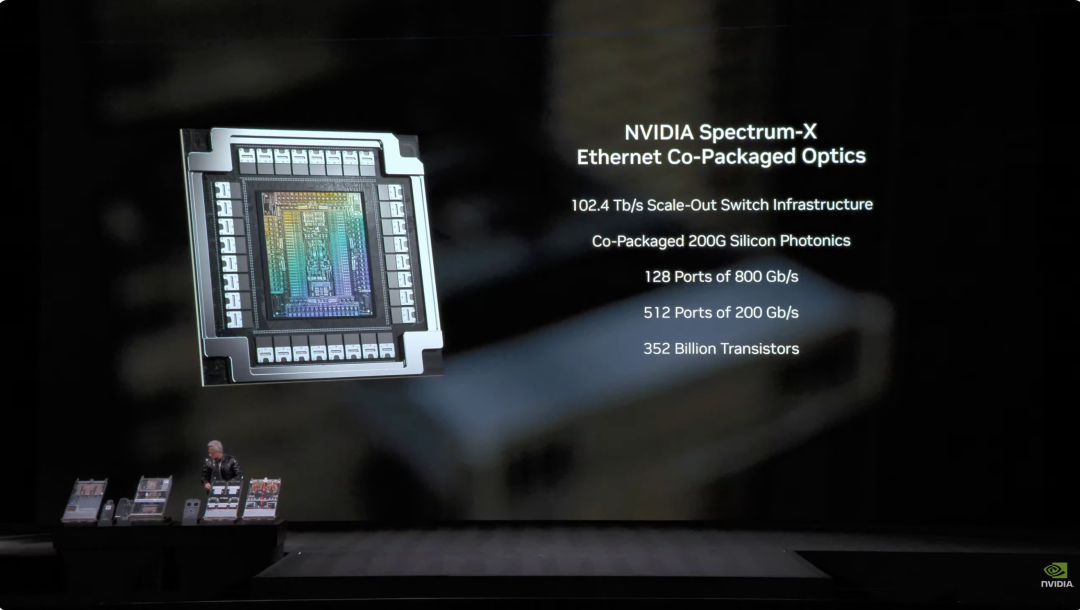
512 通道,每通道 200Gbps,实现更高速数据传输 -
集成台积电 COOP 工艺的硅光子技术 -
配备共封装光学接口(copackaged optics) -
3520 亿个晶体管
-
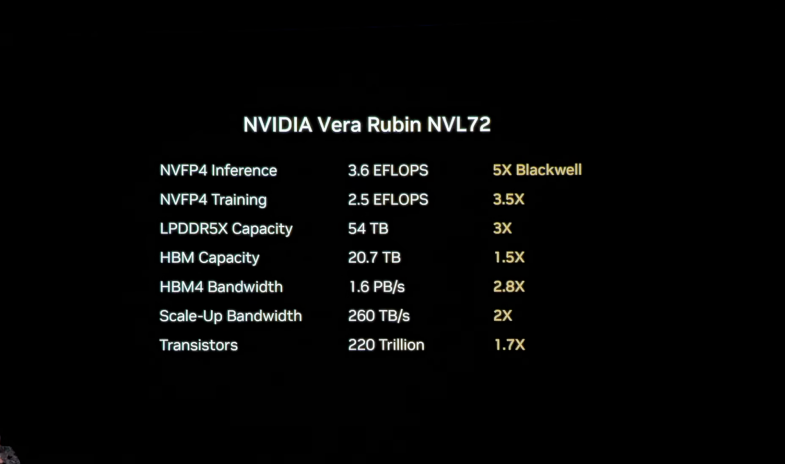
推理算力达 3.6 EFLOPS,是上一代Blackwell的5倍。
-
训练性能 2.5 EFLOPS,提升3.5倍。
-
功耗是前代 2 倍,但吞吐量(每瓦/每美元生成的 Token 数)是 10 倍。
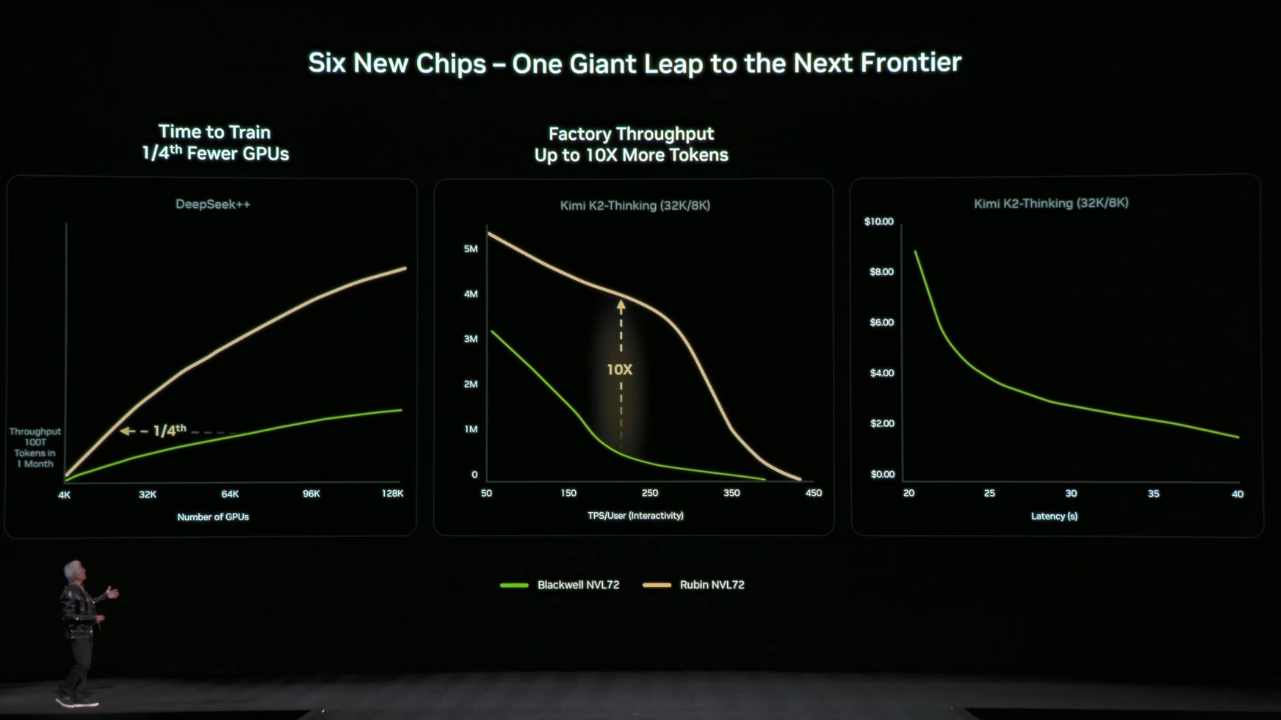
最关键的:训练一个10万亿参数模型,只需Blackwell 1/4 的系统数量,单 Token 成本降至 1/10。
更惊艳的是工程设计——从前超算节点43根线缆、2小时组装,如今零线缆设计搭配6根液冷管线,5分钟即可完成部署,机架后3.2公里长的铜缆构成 NVLink 主干网。
老黄调侃道:“这几百磅重的家伙,得体格好的 CEO 才扛得住”。
对企业而言,性能跃升直接转化为真金白银:训练10万亿参数模型仅需1/4的 Blackwell 系统,生成单个 Token 成本降至1/10,每瓦每美元的 Token 吞吐量提升10倍。对造价500亿美元的千兆瓦数据中心来说,这意味着营收能力直接翻倍,彻底改写 AI 算力的成本逻辑。
开源为王!Nemotron引领AI范式转移
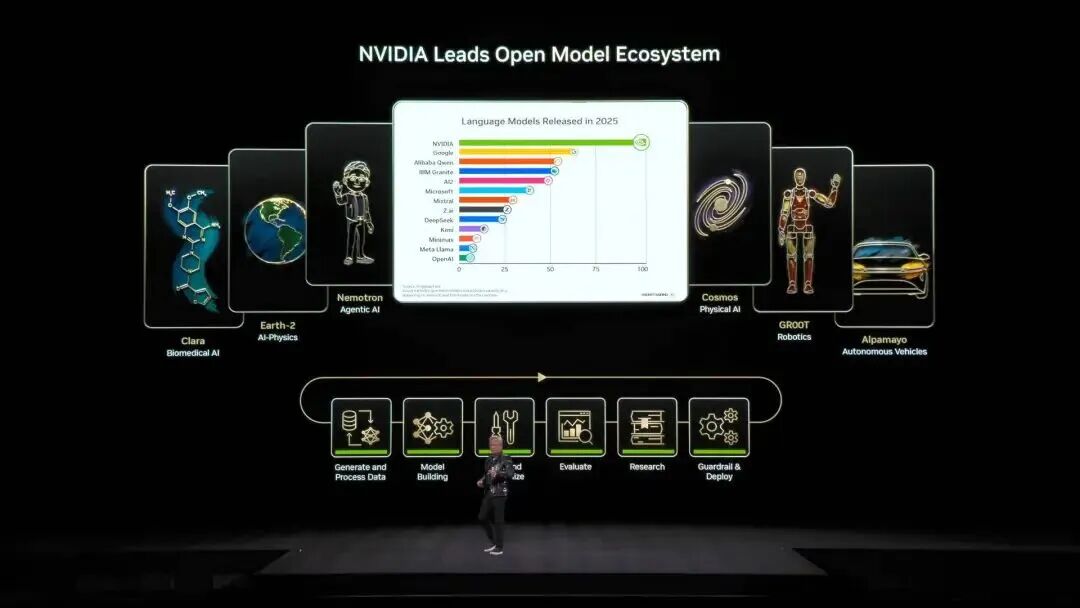
黄仁勋直言,去年 DeepSeek V1 的突破震惊世界,这款首个开源推理系统点燃了行业创新浪潮。PPT上清晰显示,国产模型 Kimi k2 与 DeepSeek V3.2 占据开源榜单前二,老黄坦言:“开源模型虽落后顶尖水平约六个月,但每半年一次的迭代速度,让所有人都无法缺席”。
英伟达也不再只“卖铲子”,而是亲自下场构建生态:Nemotron 3开源模型系列正式亮相,包含 Nano(300亿参数)、Super(1000亿参数)、Ultra(5000亿参数)三档规格,采用混合潜在专家架构,Token 处理吞吐量较上代提升4倍,安永、思科、Zoom 等企业已率先采用。同时,DGX Cloud 超级计算机搭配 La Proteina、OpenFold 3 等模型,将开源生态延伸至生物医药、自动驾驶等关键领域。
英伟达的下一个野心:征服物理世界。
-
训练计算机(如GB300超算)
-
推理计算机(机器人/汽车的“边缘大脑”)
-
模拟计算机(Omniverse,提供虚拟物理训练场)
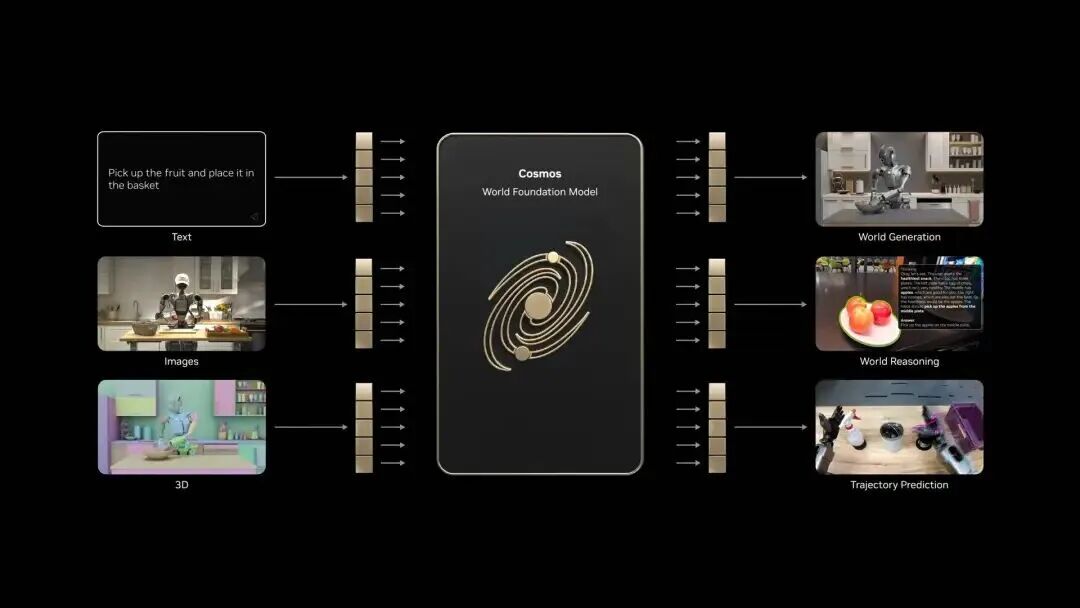
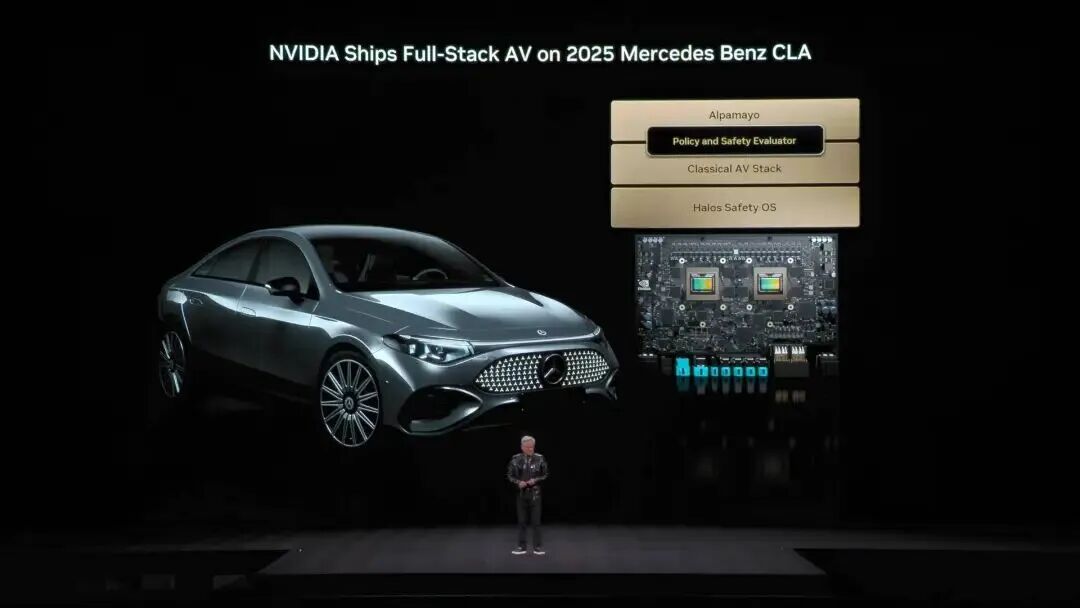
发布会上,老黄还特地展示了英伟达的机器人战略。
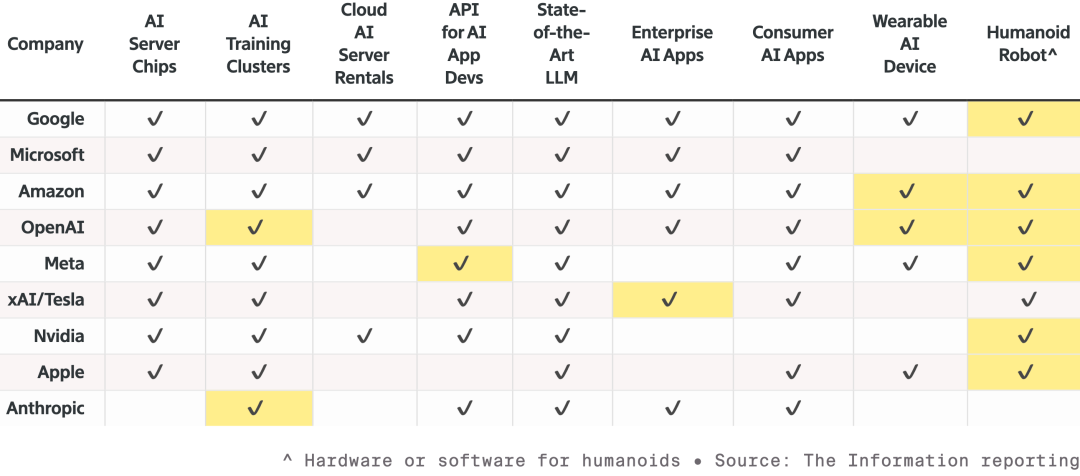
波士顿动力、Agility 的人形与四足机器人轮番登场,迪士尼萌系机器人更是引发全场欢呼,老黄调侃:“它们在计算机中被设计、制造,在面对重力前就完成了千万次测试”。所有机器人均搭载 Jetson 小型计算机,在 Omniverse Isaac 模拟器中完成训练,而英伟达正将这套技术整合进西门子、新思科技的工业体系,宣告“工厂本身就是最大的机器人”。
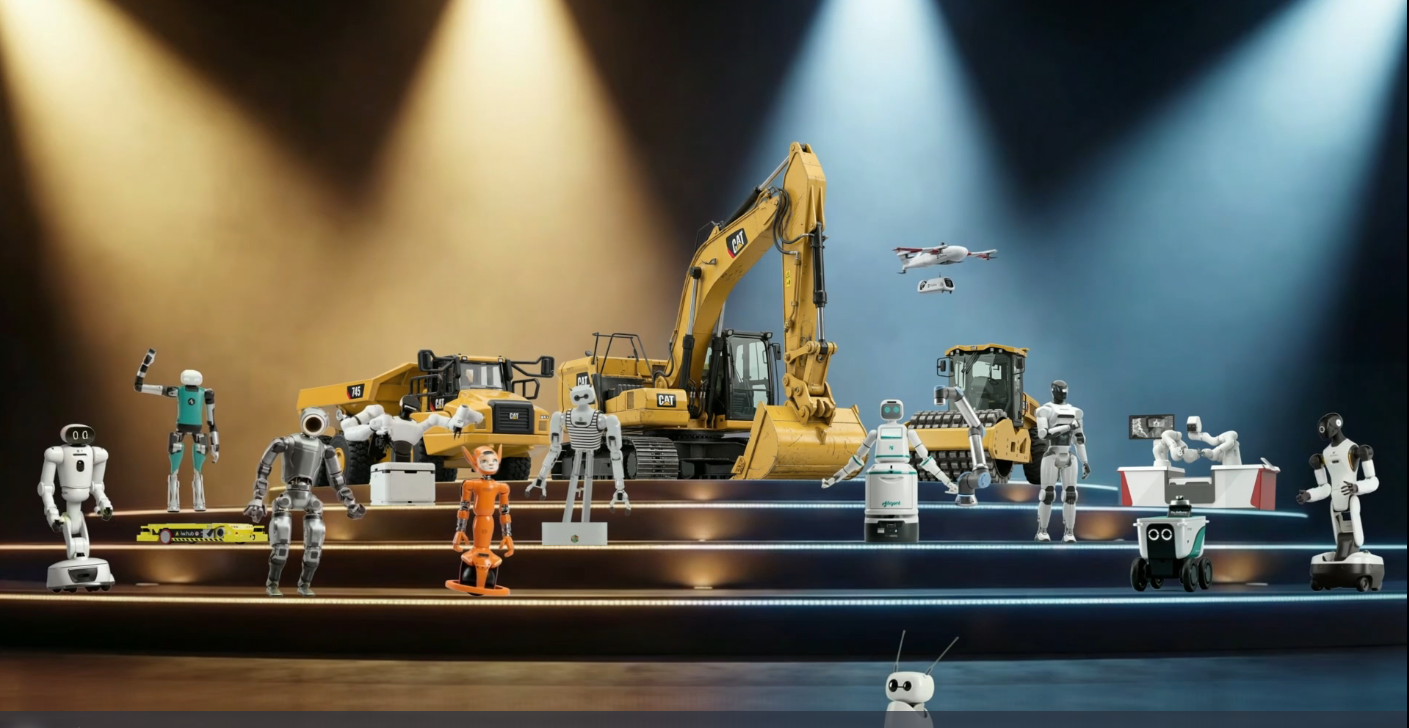
在AI泡沫论四起的今天,黄仁勋用一场从“核弹级”硬件到“杀手级”应用的全景演示,回答了最根本的问题:AI到底能做什么?英伟达的战略路径无比清晰:从赋能虚拟世界,到亲手塑造物理世界。
“过去我们为虚拟世界造芯,现在要让AI走进真实世界。”黄仁勋的这句话,道破了英伟达的战略转型。从2.5吨的算力巨兽到毫米级的机器人,从开源模型到工业级解决方案,英伟达正在用全栈能力定义AI的下一个时代——不是颠覆自己,而是重构整个科技产业的底层逻辑。